Управление файлами cookie, которые используются для рекламы, таких как персонализация рекламы, ремаркетинг и анализ эффективности рекламы.
24.06.2020
Основной синтаксис
User-Agent: робот для которого будут применяться следующие правила (например, «Googlebot»)
Disallow: страницы, к которым вы хотите закрыть доступ (можно указать большой список таких директив с каждой новой строки)
Каждая группа User-Agent / Disallow должны быть разделены пустой строкой. Но, не пустые строки не должны существовать в рамках группы (между User-Agent и последней директивой Disallow).
Символ хэш (#) может быть использован для комментариев в файле robots.txt: для текущей строки всё что после # будет игнорироваться. Данные комментарий может быть использован как для всей строки, так в конце строки после директив.
Каталоги и имена файлов чувствительны к регистру: «catalog», «Catalog» и «CATALOG» – это всё разные директории для поисковых систем.
Host: применяется для указание Яндексу основного зеркала сайта. Поэтому, если вы хотите склеить 2 сайта и делаете постраничный 301 редирект, то для файла robots.txt (на дублирующем сайте) НЕ надо делать редирект, чтобы Яндекс мог видеть данную директиву именно на сайте, который необходимо склеить.
Crawl-delay: можно ограничить скорость обхода вашего сайта, так как если у вашего сайта очень большая посещаемость, то, нагрузка на сервер от различных поисковых роботов может приводить к дополнительным проблемам.
Регулярные выражения: для более гибкой настройки своих директив вы можете использовать 2 символа
* (звездочка) – означает любую последовательность символов
$ (знак доллара) – означает конец строки
Основные примеры использования robots.txt
Запрет на индексацию всего сайта
User-agent: *
Disallow: /
Эту инструкцию важно использовать, когда вы разрабатываете новый сайт и выкладываете доступ к нему, например, через поддомен.
Очень часто разработчики забывают таким образом закрыть от индексации сайт и получаем сразу полную копию сайта в индексе поисковых систем. Если это всё-таки произошло, то надо сделать постраничный 301 редирект на ваш основной домен.
А такая конструкция ПОЗВОЛЯЕТ индексировать весь сайт:
User-agent: *
Disallow:
Запрет на индексацию определенной папки
User-agent: Googlebot
Disallow: /no-index/
Запрет на посещение страницы для определенного робота
User-agent: Googlebot
Disallow: /no-index/this-page.html
Запрет на индексацию файлов определенного типа
User-agent: *
Disallow: /*.pdf$
Разрешить определенному поисковому роботу посещать определенную страницу
User-agent: *
Disallow: /no-bots/block-all-bots-except-rogerbot-page.html
User-agent: Yandex
Allow: /no-bots/block-all-bots-except-Yandex-page.html
Ссылка на Sitemap
User-agent: *
Disallow:
Sitemap: http://www.example.com/none-standard-location/sitemap.xml
Нюансы с использованием данной директивы: если у вас на сайте постоянно добавляется уникальный контент, то
-
лучше НЕ добавлять в robots.txt ссылку на вашу карту сайта,
-
саму карту сайта сделать с НЕСТАНДАРТНЫМ названием sitemap.xml (например, my-new-sitemap.xml и после этого добавить эту ссылку через «вебмастерсы» поисковых систем),
так как, очень много недобросовестных вебмастеров парсят с чужих сайтов контент и используют для своих проектов.
Шаблон для WordPress
Allow: /wp-content/themes/*.js
Allow: /wp-content/themes/*.css
Allow: /wp-includes/js/*.css Allow: /wp-includes/js/*.js
Allow: /wp-content/plugins/*.js
Allow: /wp-content/plugins/*.css
Шаблон для Joomla
Allow: /templates/*.css
Allow: /templates/*.js
Allow: /templates/*.png
Allow: /templates/*.gif
Allow: /templates/*.ttf
Allow: /templates/*.svg
Allow: /templates/*.woff
Allow: /components/*.css
Allow: /components/*.js
Allow: /media/*.js Allow: /media/*.css
Allow: /plugins/*.css Allow: /plugins/*.js
Шаблон для Bitrix
Allow: /bitrix/templates/*.js
Allow: /bitrix/templates/*.png
Allow: /bitrix/templates/*.jpg
Allow: /bitrix/templates/*.gif
Allow: /bitrix/cache/css/*.css
Allow: /bitrix/cache/js/s1/*.js
Allow: /upload/iblock/*.jpg
Allow: /upload/iblock/*.png
Allow: /upload/iblock/*.gif
Шаблон для DLE
Allow: /engine/classes/*.css
Allow: /engine/classes/*.js
Allow: /templates/
Разобравшись с простым синтаксисом команд для робота, также важно учесть и такие значения мета-тега robots
Данному мета-тегу можно присвоить четыре варианта значений.
Атрибут content может содержать следующие значения:
index, noindex, follow, nofollow
Если значений несколько, они разделяются запятыми.
В настоящее время лишь следующие значения важны:
Директива INDEX говорит роботу, что данную страницу можно индексировать.
Директива FOLLOW сообщает роботу, что ему разрешается пройтись по ссылкам, присутствующим на данной странице. Некоторые авторы утверждают, что при отсутствии данных значений, поисковые сервера по умолчанию действуют так, как если бы им даны были директивы INDEX и FOLLOW.
Итак, глобальные директивы выглядят так:
Индексировать всё = INDEX, FOLLOW
Не индексировать ничего = NOINDEX,NOFLLOW
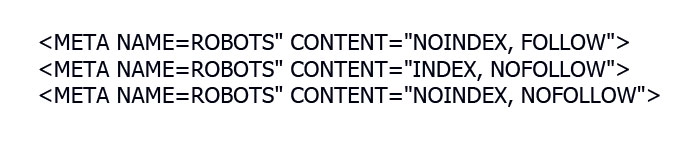
Примеры мета-тега robots:
Заказывайте хостинг и выбирайте домен в компании «Хостинг Украина».
У нас качественный и надежный сервис, удобное система управления через админ-панель, интеллектуальные системы защиты и техническая поддержка, которая поможет решить все возникающие вопросы в любое время суток.
Наши цены: SSD хостинг от 1$, VPS на SSD от 12$, Cloud (облачный) хостинг от 3$, облачный VPS от 6$.
Присоединяйтесь к «Хостинг Украина» и мы позаботимся о технической стороне вашего бизнеса.
User-agent: *
Disallow: /page/*html$
Это всем известно.
Но вот что интересно, следующий пример тоже работает, проверено через Google Search Console:
User-agent: *
Disallow: /page/*/